

雲林縣府偕勞動部協調艾杰旭勞資爭議 勞資就薪資調整達成共識
【記者 劉峻文/雲林 報導】艾杰旭顯示玻璃股份有限公司因調薪問題引發工會罷工之爭議,於7日下午4時30分假經濟部雲林產業園區大北勢區服務中心及艾杰旭公司會議室等兩地,召開勞資協商會議,由雲林縣政府勞動暨青年事務發展處張世忠處長與勞動部勞資關係司王厚偉司長共同主持,經冗長協商斡旋過程,於晚上23點30分時結束,歷時7小時
5 小時前・台灣好報
(媒角抵加/林承志綜合報導)驗收AI炒股工具的下單策略,可先看比較基準、未參與訓練的測試,以及成本與訂單變動後的表現。倫敦大學學院研究者10月2日公開一份券商交易模擬論文,報告以PPO強化學習調整下單速度時,即使獎勵計算通過檢查,部分策略仍學得不準。台灣金融團隊因此多了一個具體驗收問題:AI在相同條件下,做出的決策與可靠策略差多少?
倫敦大學學院研究者Siu Tung Wong與Carlo Campajola讓PPO學習券商的交易速度:下單快有成本,慢則讓持倉承受價格風險。作者在原論文檢查獎勵公式的離散實作,再把AI與解析參考策略比較。無隨機訂單流時,選定的前饋神經網路策略能接近參考動作;加入隨機訂單流後,測試的兩種網路策略仍不準。
這裡的「獎勵」是訓練時評量動作好壞的分數。驗收時可以分開問兩件事:分數是否忠實反映系統的目的,以及學習後的策略是否真的做出較好的決定。前者是評分規則的檢查,後者需要實際比較動作與執行結果。
PPO訓練包含估計未來得分的模型,稱為critic。作者在120個測試狀態比較兩個相近動作,發現以critic估值推算的排序,與重複模擬報酬同方向的比例為51.7%。論文第4節的診斷將較弱的動作排序列為學習困難的可能原因;這個比例衡量的是局部決策比較。
估分模型與實際表現之間的落差,也是既有研究討論的問題。Ilyas等人在2020年版本的〈A Closer Look at Deep Policy Gradients〉指出,學到的價值估計與真實價值函數可能有差距,訓練使用的代理目標也可能偏離實際獎勵。這類診斷把問題從最後的總分,往前追到產生決策的過程。
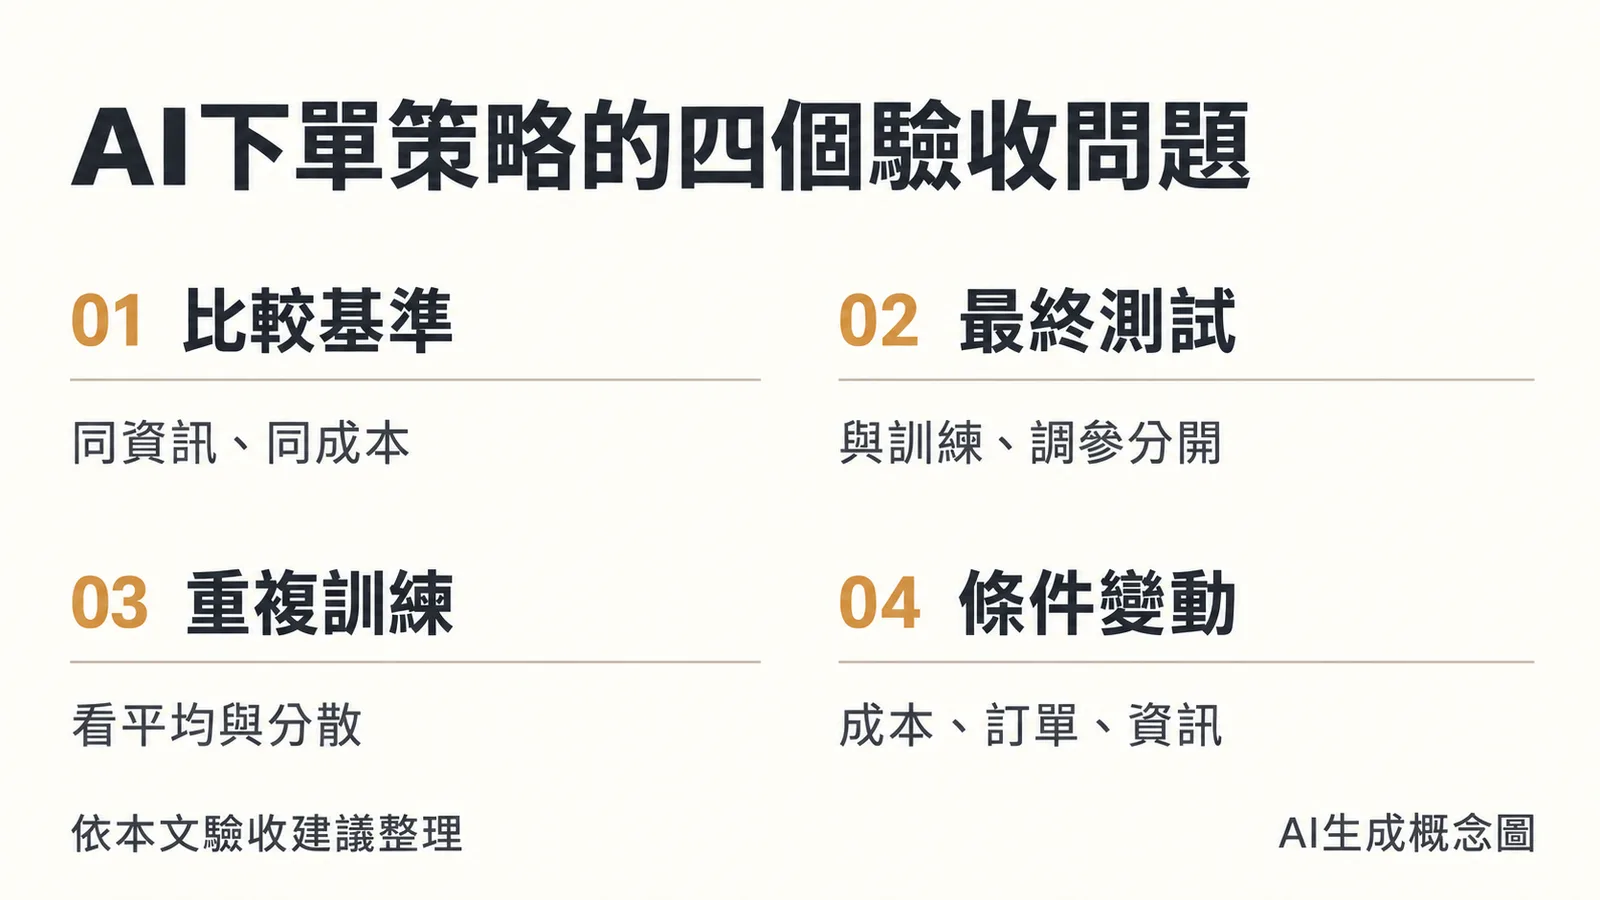
OpenAI的Spinning Up研究方法說明提出公平比較、使用多個隨機種子,以及區分調整參數與最終實驗等原則。比較基準也要投入相當的調整努力,最後報告保留全部結果。
媒角抵加依這些評測原則與交易執行情境,整理四個可向系統供應方提出的問題:
這四項問題適合用在採購提案、模型更新或內部驗收會議。供應方提供的資料若能讓兩套策略在相同條件下比較,團隊就能逐項討論改善、代價與適用範圍。
作者另以已知策略為起點,讓PPO學習調整量。論文第5節報告,執行成本減半時,五次獨立訓練皆改善模擬得分,但只縮小原策略與新成本參考策略得分差距的2.22%;其他成本條件未見可靠改善。
對導入團隊而言,這提供一種可比較的測試安排:保留原策略,記錄AI增加的調整,再分別量測兩者在新條件下的效果。若考慮這種做法,驗收報告也可以列出調整幅度、績效差距及何種情況下會退回原策略。
金管會2024年的《金融業運用人工智慧(AI)指引》建議金融機構依AI目的訂定穩健性指標與門檻。對較高風險、影響較大的系統,可考量在與日常作業分離的環境測試,納入市場壓力情境;使用後持續監控效能與變化。這份行政指引也說明,人工監督方式可依影響程度安排,包括審查、核准、最終決定或安全關閉。
金融團隊可以把這些項目寫成一份驗收文件:每項指標的通過門檻、測試資料、觸發停用或重新驗證的條件,以及有權處理異常的負責人。準備採用交易工具的使用者,則可先向業者索取適用市場、費用條件、執行權限與錯誤處理說明,確認工具提供的是建議,還是會直接送出委託。
實際操作的確認權,可延伸閱讀〈AI替你按確認,錯了誰收拾?〉;關於代理越界後的處理責任,則可參考OpenAI代理安全事件的報導。更多導入與驗收議題收錄在AI工作流程。


